
ChatGPT-6とClaude Opus 5.5を1日5件のクレームで比較テストしたところ、大きな差が見られました。
勝者を決定づける:ChatGPT-6とClaude Opus 5.5を5つの日常タスクで徹底的に比較。一方が他方を圧倒的に凌駕し、その差は歴然としていた!
知っておくべき最も重要なこと
- クロードは、複雑な請求内容を深く理解し、不正なニーズ(例えば、パーティー計画における相互汚染など)を予測し、統合的でインテリジェントなソリューションを提供することに長けています。
- クロードは、問題を捉え直し、具体的な人的利益に焦点を当て、根本的な動機を理解するという、卓越した能力を発揮した。これは、より深い戦略的アプローチを反映している。
- クロードは知識の深さでは優れていたものの、ChatGPTの分かりやすく段階的なアプローチは、忙しい日常生活の整理といった複雑な状況に対して、より実用的で即効性のある解決策を提供する上で効果的だった。
OpenAIとAnthropicは今月、ChatGPT-6とClaude Opus 5.5という画期的な新しいAIモデルをそれぞれ発表した。どちらも非常に優れた能力を備えており、ほとんどのユーザーが求める以上の機能を提供している。
OpenAIのGPT-6ファミリーは、同社がこれまでに開発した中で最も優れたモデルであるGPT-6 Astraをベースとしており、推論、専門的な業務、プログラミング、ブラウジング、コンピュータ利用といった分野で目覚ましい進歩を遂げています。最新のGPT-6 Solは、その高度な知能を日常業務向けに設計されたバージョンに多く取り入れ、より高速でコスト効率の高い推論モデルとして位置づけられています。
Claude Opus 5.5 は、少し異なる角度からこの問題に取り組んでいます。Anthropic は、これを、要求に必要な労力量を決定する適応推論を備えた、長期的な認知エージェントベースの作業向けに設計されたモデルと説明しています。コンテキスト ウィンドウは最大 100 万トークンで、最大 128,000 トークンの出力を生成できます。Anthropic によると、ほとんどのタスクで最上位モデルである Claude Fable 5.1 とほぼ同等のパフォーマンスを発揮し、実行コストは以前の Opus リリースよりも 40% 低くなっています。Anthropic はまた、モデルが自然な方法で通信し、書き込み指示に従う点も改善されたと強調しています。
これらの違いは印象的ですが、日常生活でどちらのチャットボットが役立つかを判断するのに役立つとは限りません。より実践的な比較については、こちらの記事をご覧ください。「Claude 4 SonnetとChatGPT-4oを7つのタスクでテストしました。どちらか一方が圧倒的に優れていました。 」
そこで、ChatGPT-6とClaude Opus 5.5に全く同じ5つの要求を提示してみました。結果は期待していたような圧倒的な勝利ではありませんでした。日常生活における要求に彼らをさらしてみたところ、次のような結果になりました。
1. 複雑で現実的な計画 — 制約条件と見積もり
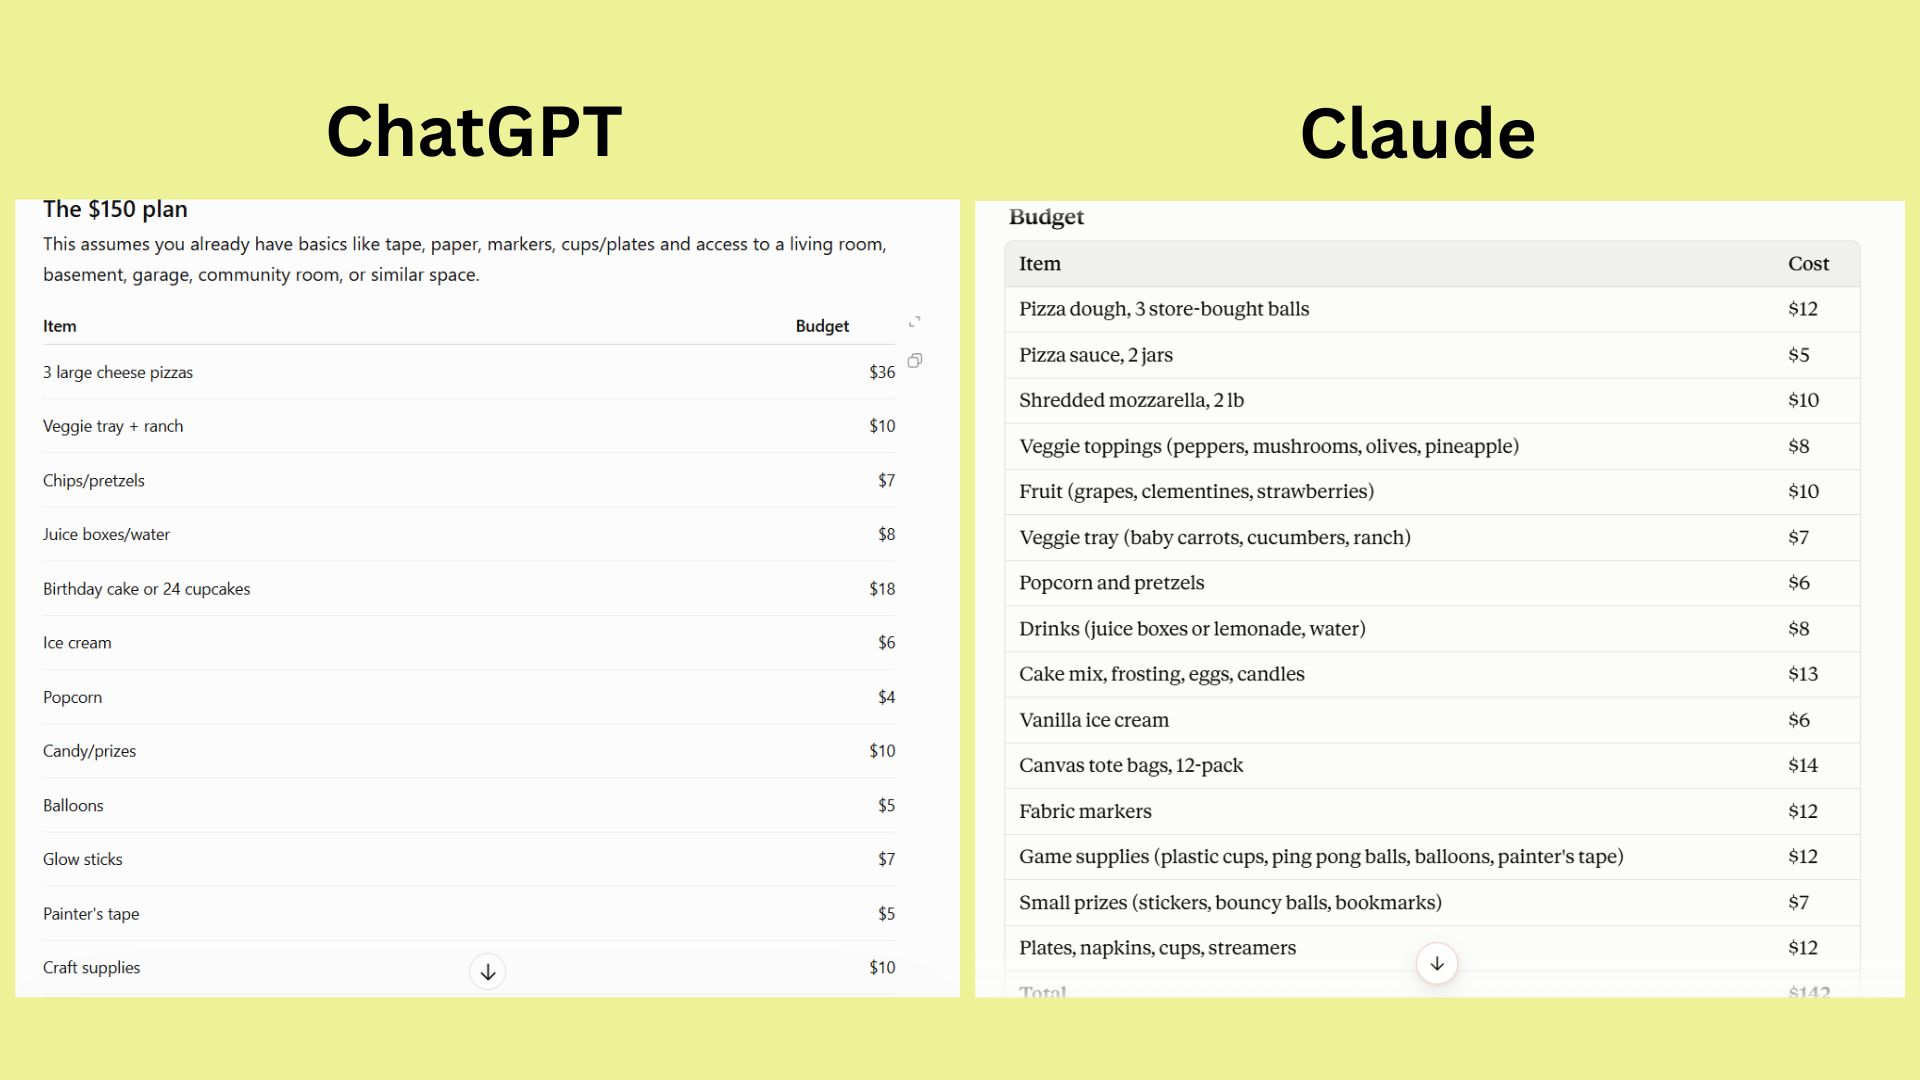
課題:8歳から11歳までの子供10人の誕生日パーティーを企画するために、150ドルの予算があります。パーティーは3時間で、雨天の場合は屋内で行う必要があり、食事を提供し、スクリーンタイムを最小限に抑える必要があります。子供のうち2人はビーガンで、1人はピーナッツアレルギーです。予算、スケジュール、アクティビティ、および代替案を含む完全な計画を作成してください。予算は150ドルを超えないようにしてください。
ChatGPTは、イベントに明確なアイデンティティと方向性を与えることで、明確な概念的枠組みを提供しました。10人の子供をもてなす親にとって、3枚のチーズピザのテイクアウトに36ドルを割り当てることは、一般的な家庭のキッチンでミニピザを自分で作るよりも実際にははるかに簡単です。また、最後に「緊急時の予備費/価格」を設定する必要性にも対応しました。
クロードはアレルギー問題や食事に関する規定を的確に予測し、パン屋のケーキと既製ミックス粉の交差汚染の問題にも対処しました。予算管理にも長けており、トートバッグに14ドル、布用マーカーに12ドルを割り当てました。これらは到着時の工作アクティビティとパーティーのお土産の両方に役立ち、費用を節約し、安価なプラスチックごみの削減にもつながりました。また、実用的で具体的なスケジュールと、運営上の問題に対する解決策も提示しました。このように包括的かつ的確な計画を実行できる能力こそが、多くの人にとってクロードを選ぶ理由であり、そのことは「ChatGPTではなくクロードを選ぶ6つの理由」という記事でも説明されています。
勝者:クロードが勝利。彼は主催者に対して、安全への真摯な配慮に基づいた、完全で完成された計画を提供したのに対し、ChatGPTは断片的な買い物リストしか提供しなかった。
2. 文章作成 — AIを人間らしく見せる
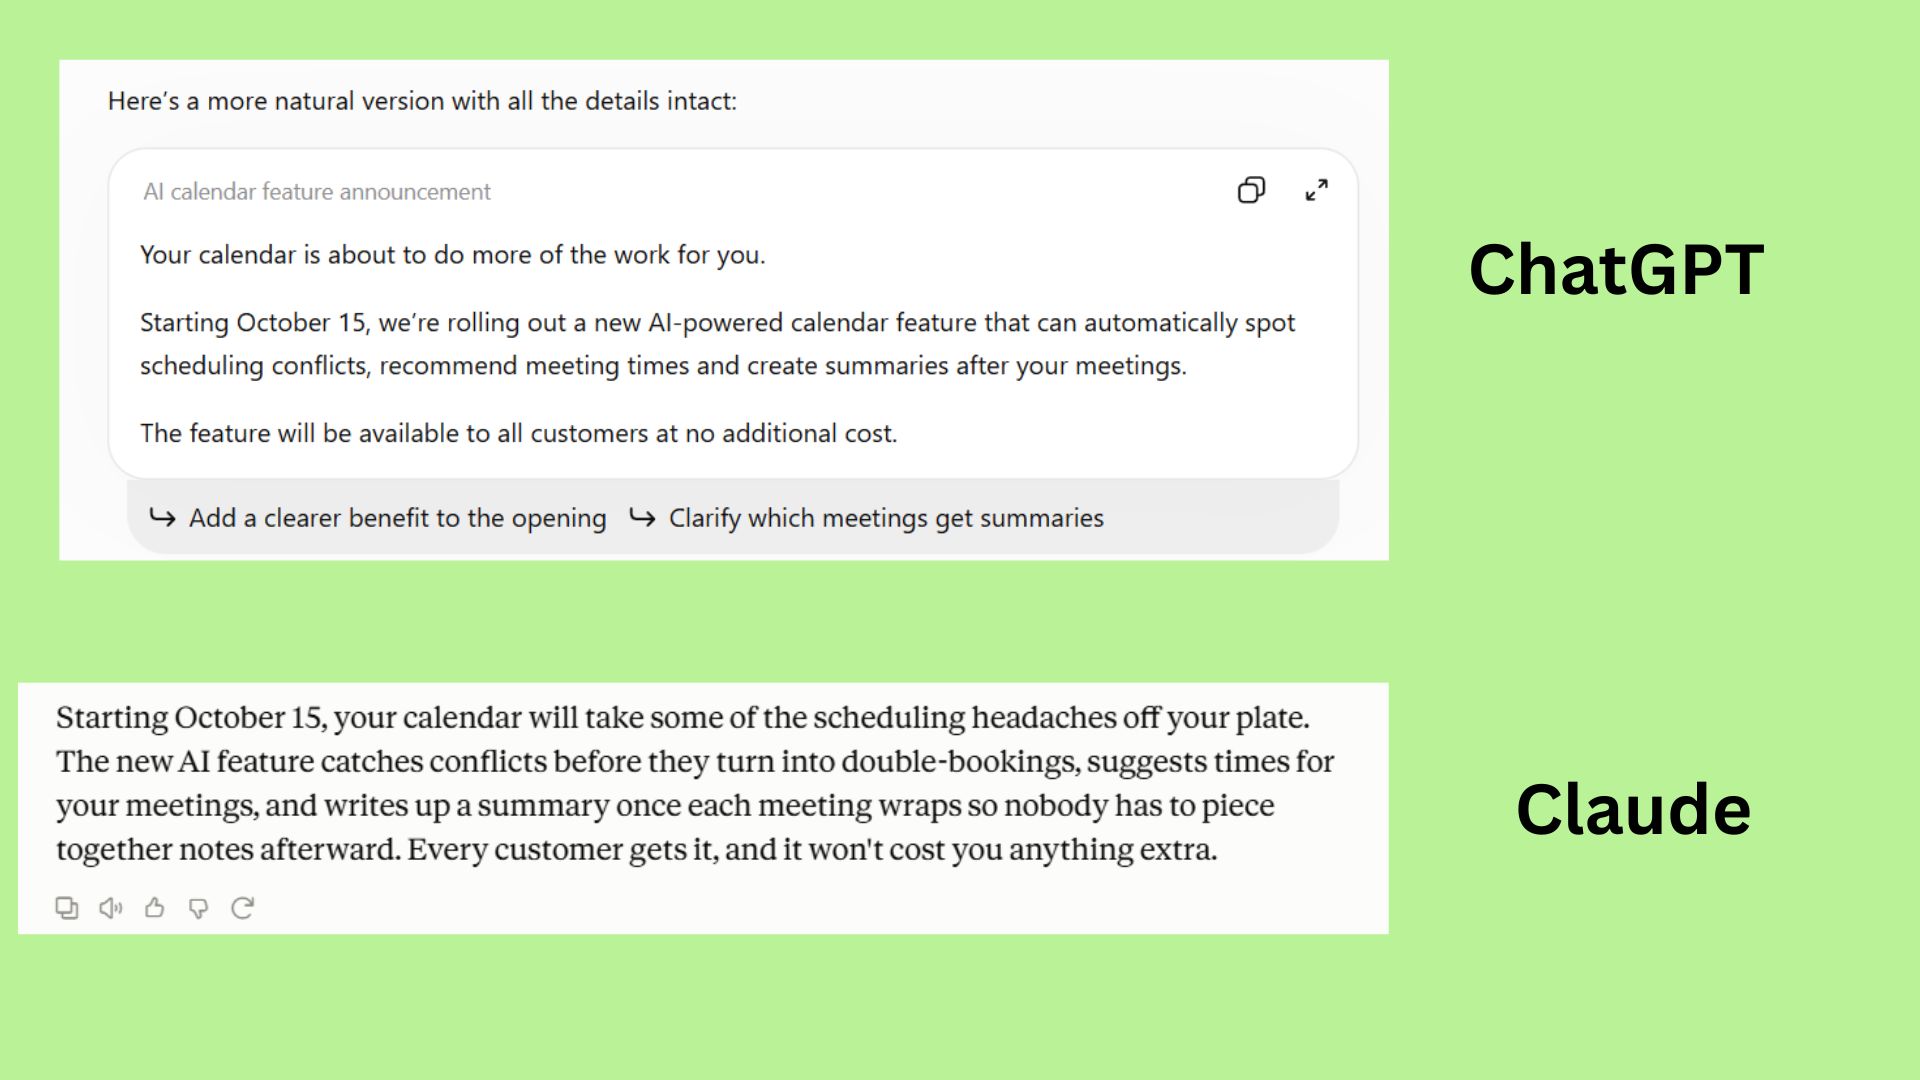
要求事項:この退屈な広告を、実際に人が読みたくなるような文章に書き直してください。事実に基づいた詳細はすべて残し、ダッシュ記号は使用せず、決まり文句は避け、「刺激的」「革命的」「画期的」「シームレス」といった言葉は使用しないでください。
「当社は、スケジュールの重複を自動的に特定し、会議の最適な日時を提案し、会議後の要約を作成する、AI搭載の新しいカレンダー機能を導入します。この機能は10月15日にリリースされ、すべてのお客様に追加料金なしでご利用いただけます。」
ChatGPTは、読者を引き込む魅力的な冒頭の一文を提示し、典型的なAI手法を避け、現実的な詳細を維持した。段落分けのおかげで、文章を素早く読み進めることができた。
クロードは要点を具体的な人的利益へと再構成し、詳細を再構成して実際の業務量削減に焦点を当てた。
勝者:Claudeが勝者となった理由は、「人間らしい」言い換えには、単に元のテキストの動詞をいくつか変更するのではなく、機能の説明方法を再考する必要があることを認識したからです。これは、 Claudeを日常的に使用する際に大きな違いを生む唯一の主張と一致しています。
3.推論 ― 答えは明確ではない
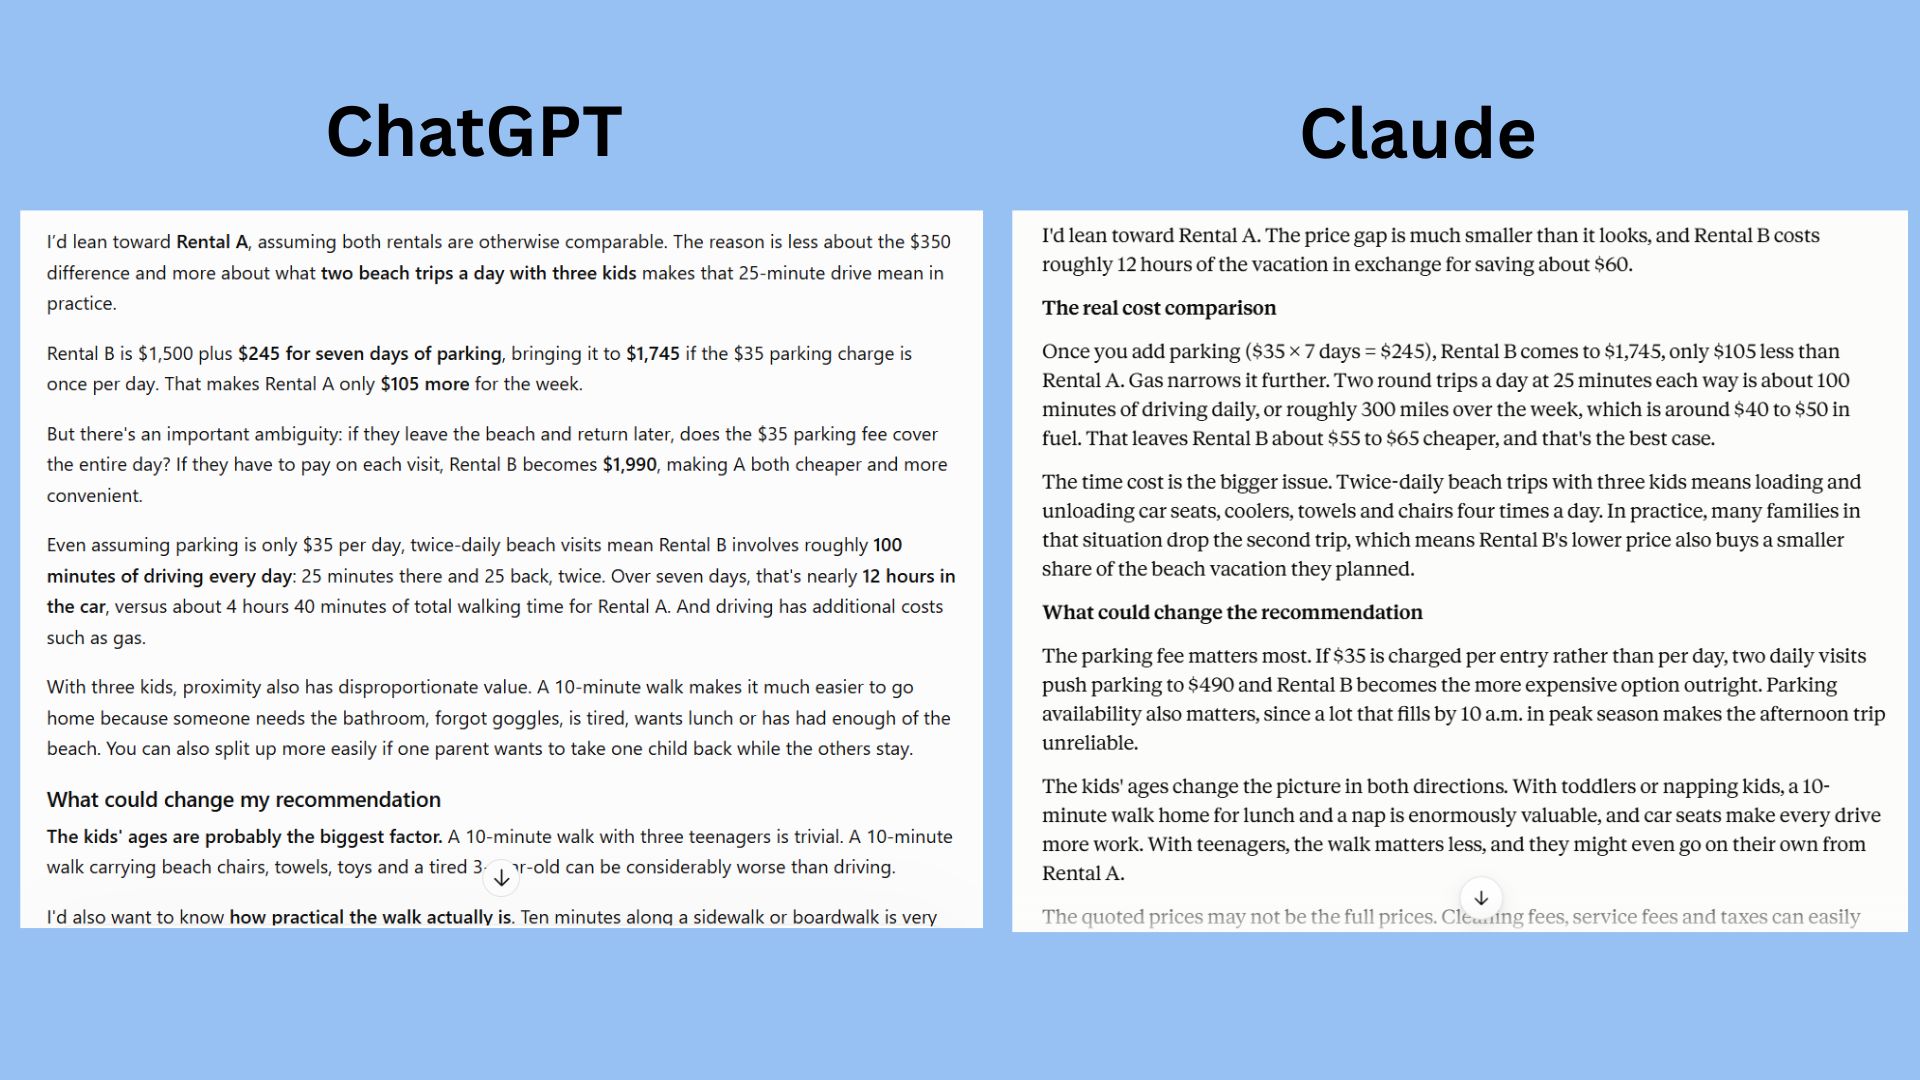
問題:ある家族が2つのバケーションレンタル物件のどちらを選ぶか迷っています。1つ目は1,850ドルで、ビーチまで徒歩10分です。2つ目は1,500ドルですが、ビーチまで車で25分かかり、さらに駐車料金として1日35ドルかかります。家族は7日間滞在し、1日に2回ビーチに行く予定です。子供は3人います。どちらの物件を選ぶべきでしょうか?単に費用を計算するだけでなく、推奨する物件を選ぶ際に考慮すべき要素を挙げ、最も重要な追加情報を教えてください。
ChatGPTは、子供の年齢に関して最も的確な反論を提示した。また、「10分間の徒歩」という距離は、周囲のインフラ(木製の遊歩道なのか、4車線の高速道路なのか、砂丘なのか?)によって大きく異なることを的確に指摘した。チャットボットは特に、最初の家であれば親が役割分担できる点(例えば、疲れた子供を一人が家に連れて帰り、もう一人が残りの二人とビーチに残るなど)を挙げた。
クロードは距離を正確に計算し、別荘を持つことによる金銭的な節約は、実際には1週間でわずか55ドルから65ドルに過ぎないことを示した。彼はまた、鋭い心理的指摘もした。1日に4回も3人の子供をチャイルドシートに乗せたり降ろしたりするとなると、家族は2回目のビーチ旅行を完全に諦める可能性が高いというのだ。さらに彼は、バケーションレンタルプラットフォームの「隠された真実」を正しく指摘した。基本料金には清掃費、サービス料、宿泊税は含まれておらず、それだけで105ドルの差が生じる可能性があるというのだ。
勝者:クロードが僅差で勝利しました。ChatGPTは個々のポイントでは最も優れた指摘をしましたが(重いビーチ用品と幼い子供を連れて歩くのは運転よりも疲れるという点)、クロードの財務分析は非常に綿密かつ正確で、隠れた手数料を予測し、通勤によって家族が予定していた外出をキャンセルせざるを得なくなるという彼の観察はまさに的を射ていたため、総合的にクロードが勝利しました。私がChatGPTではなくクロードを選ぶ6つの理由をご覧ください。
4.複数の選択肢がある場合、何が最も重要かをどのように判断すればよいでしょうか?
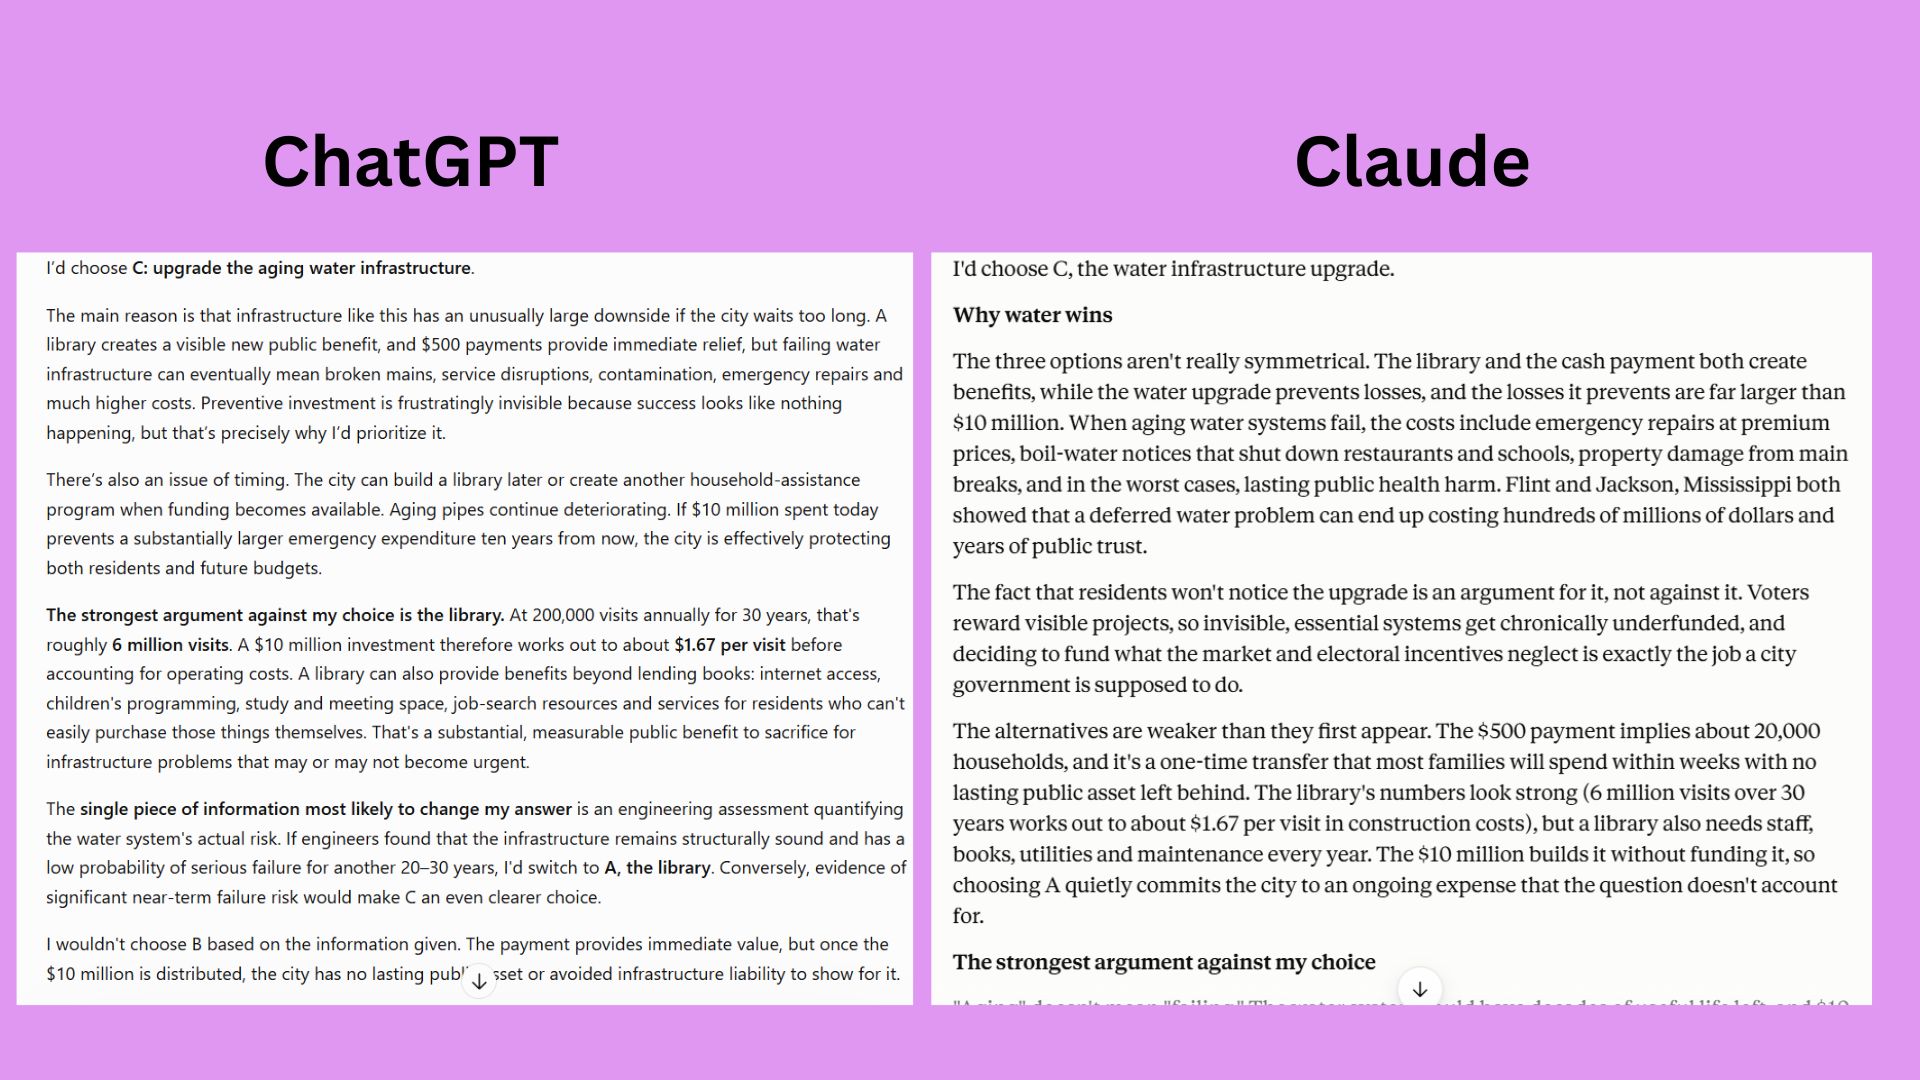
主張:ある都市には1000万ドルの予算があり、3つの選択肢がある。
a) 年間200,000万人の利用が見込まれる、少なくとも30年間利用できる新しい公共図書館の建設。
b) 各世帯に500ドルの一時金を支給する。
c) 老朽化した水道インフラの改修。これは、何か問題が発生しない限り住民が気づかない問題である。
市は選択肢を一つしか選べません。最善だと思う選択肢を選び、その理由を説明し、その選択に対する最も有力な反論を挙げ、さらにどのような追加情報があれば答えが変わる可能性があるかを説明してください。どの選択肢も良いと言って問題を回避しないでください。
ChatGPTはすべての指示に正確に従い、オプションCを擁護する分かりやすい説明を提供した。また、技術評価の基準も明確に定義した。
クロードは自身の選択を自治体のインセンティブという観点から捉え、選挙政治が無視する事柄に資金を提供することが、市行政の主要な機能であると認識した。
勝者:クロードの勝ち。彼の回答の方がはるかに優れていた。ボットは公共財政管理に関する専門知識を持っているように見えたが、ChatGPTの回答は定型的で表面的なものに感じられた。
5.決定的な試練 ― 曖昧な要求+主体性
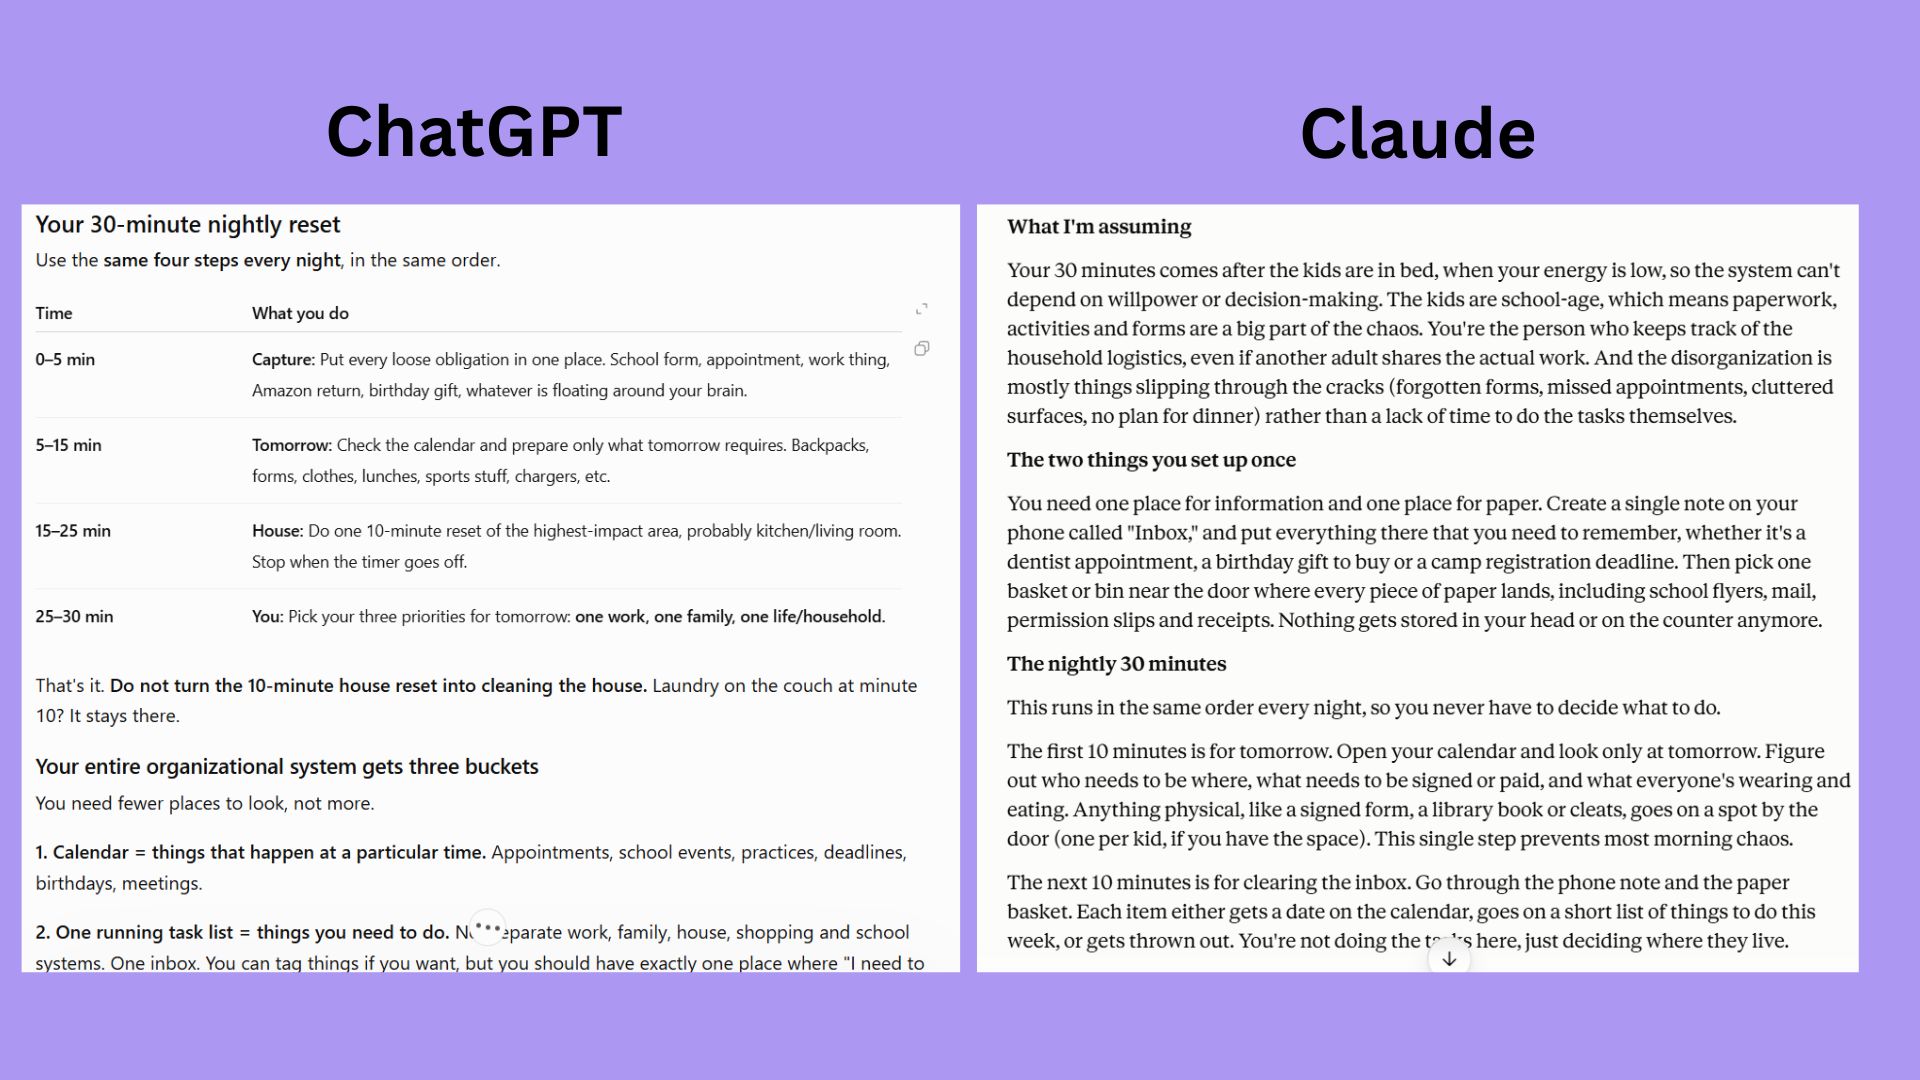
お願い:私の生活は整理整頓ができていないと感じています。3人の子供がいて、フルタイムの仕事、家事もこなさなければならず、毎晩、物事を整理する時間は30分程度しかありません。現実的に続けられるようなシステムを構築してください。ありきたりな生産性向上のアドバイスは不要です。必要に応じて合理的な仮定を立て、その仮定の内容を説明し、今夜から始められるような具体的な方法を提案してください。
ChatGPTは、ユーザーが計画を立てたり、どこから始めればよいかを推測したりする必要がないように、手順を細かく分けた説明など、燃え尽き症候群を防ぐための簡単な方法を提供しました。
クロードは精神的な負担について言及し、混乱の根本原因を鋭く洞察力豊かに見抜いた。また、5人家族において片方の親だけが家事を切り盛りすることは不可能であることを認識し、実行可能な家事を分担するという有益なアドバイスも提供した。
勝者:ChatGPTが勝利したのは、その認知フレームワークが、疲弊した親の精神的な負担をより効果的に軽減するからである。Claudeは家庭の整理整頓に役立つ優れたルーティンを提供したが、ChatGPTは仕事、家庭、そして生活が互いに破滅し合うのを防ぐ意思決定フィルターを提供した。
総合優勝者:クロード
5回のテストの結果、Claude Opus 5.5は4回で優れた性能を発揮しました。しかし、私が驚いたのは、全く関係のないタスクにおいても、これらのモデル間の差が一貫して維持されたことです。Claudeはより深く掘り下げる傾向があります。
私が誕生日パーティーの企画を依頼したとき、彼は交差汚染を考慮し、二つの目的を兼ねる方法を見つけてくれました。私がバケーションレンタルについて提起したとき、彼は私が明示的に言及していなかった費用を計算し、運転の不便さが実際に家族の行動を変えるかどうかを検討しました。10万ドルの予算を投じる都市の予算配分を決める際でさえ、彼は明白なメリットとデメリットだけでなく、そもそもなぜ政府がそのような決定を下すのかという理由まで考慮に入れました。
まさにこの点で、Claude Opus 5.5 は最大の強みを発揮しました。対照的に、ChatGPT-6 は全体的に効率化されており、これは ChatGPT の確立された性質と完全に一致しています。ChatGPT は、どのモデルであっても、より簡潔で冗長でない回答を提供し、より迅速に要点にたどり着く傾向があります。しかし、これはまた、その回答が常に Claude の回答ほど洞察に富んでいるわけではないことを意味し、そのため一部のユーザーは特定のタスクで Claude を好みます。ChatGPT -5 よりも Claude を選択する説得力のある理由については、こちらをご覧ください。とはいえ、このアプローチ (ChatGPT の簡潔なスタイル) は、最近のテストで利点であることが証明されました。
コメントは締め切りました。